Publications

You can also find my articles on Google Scholar.

2026
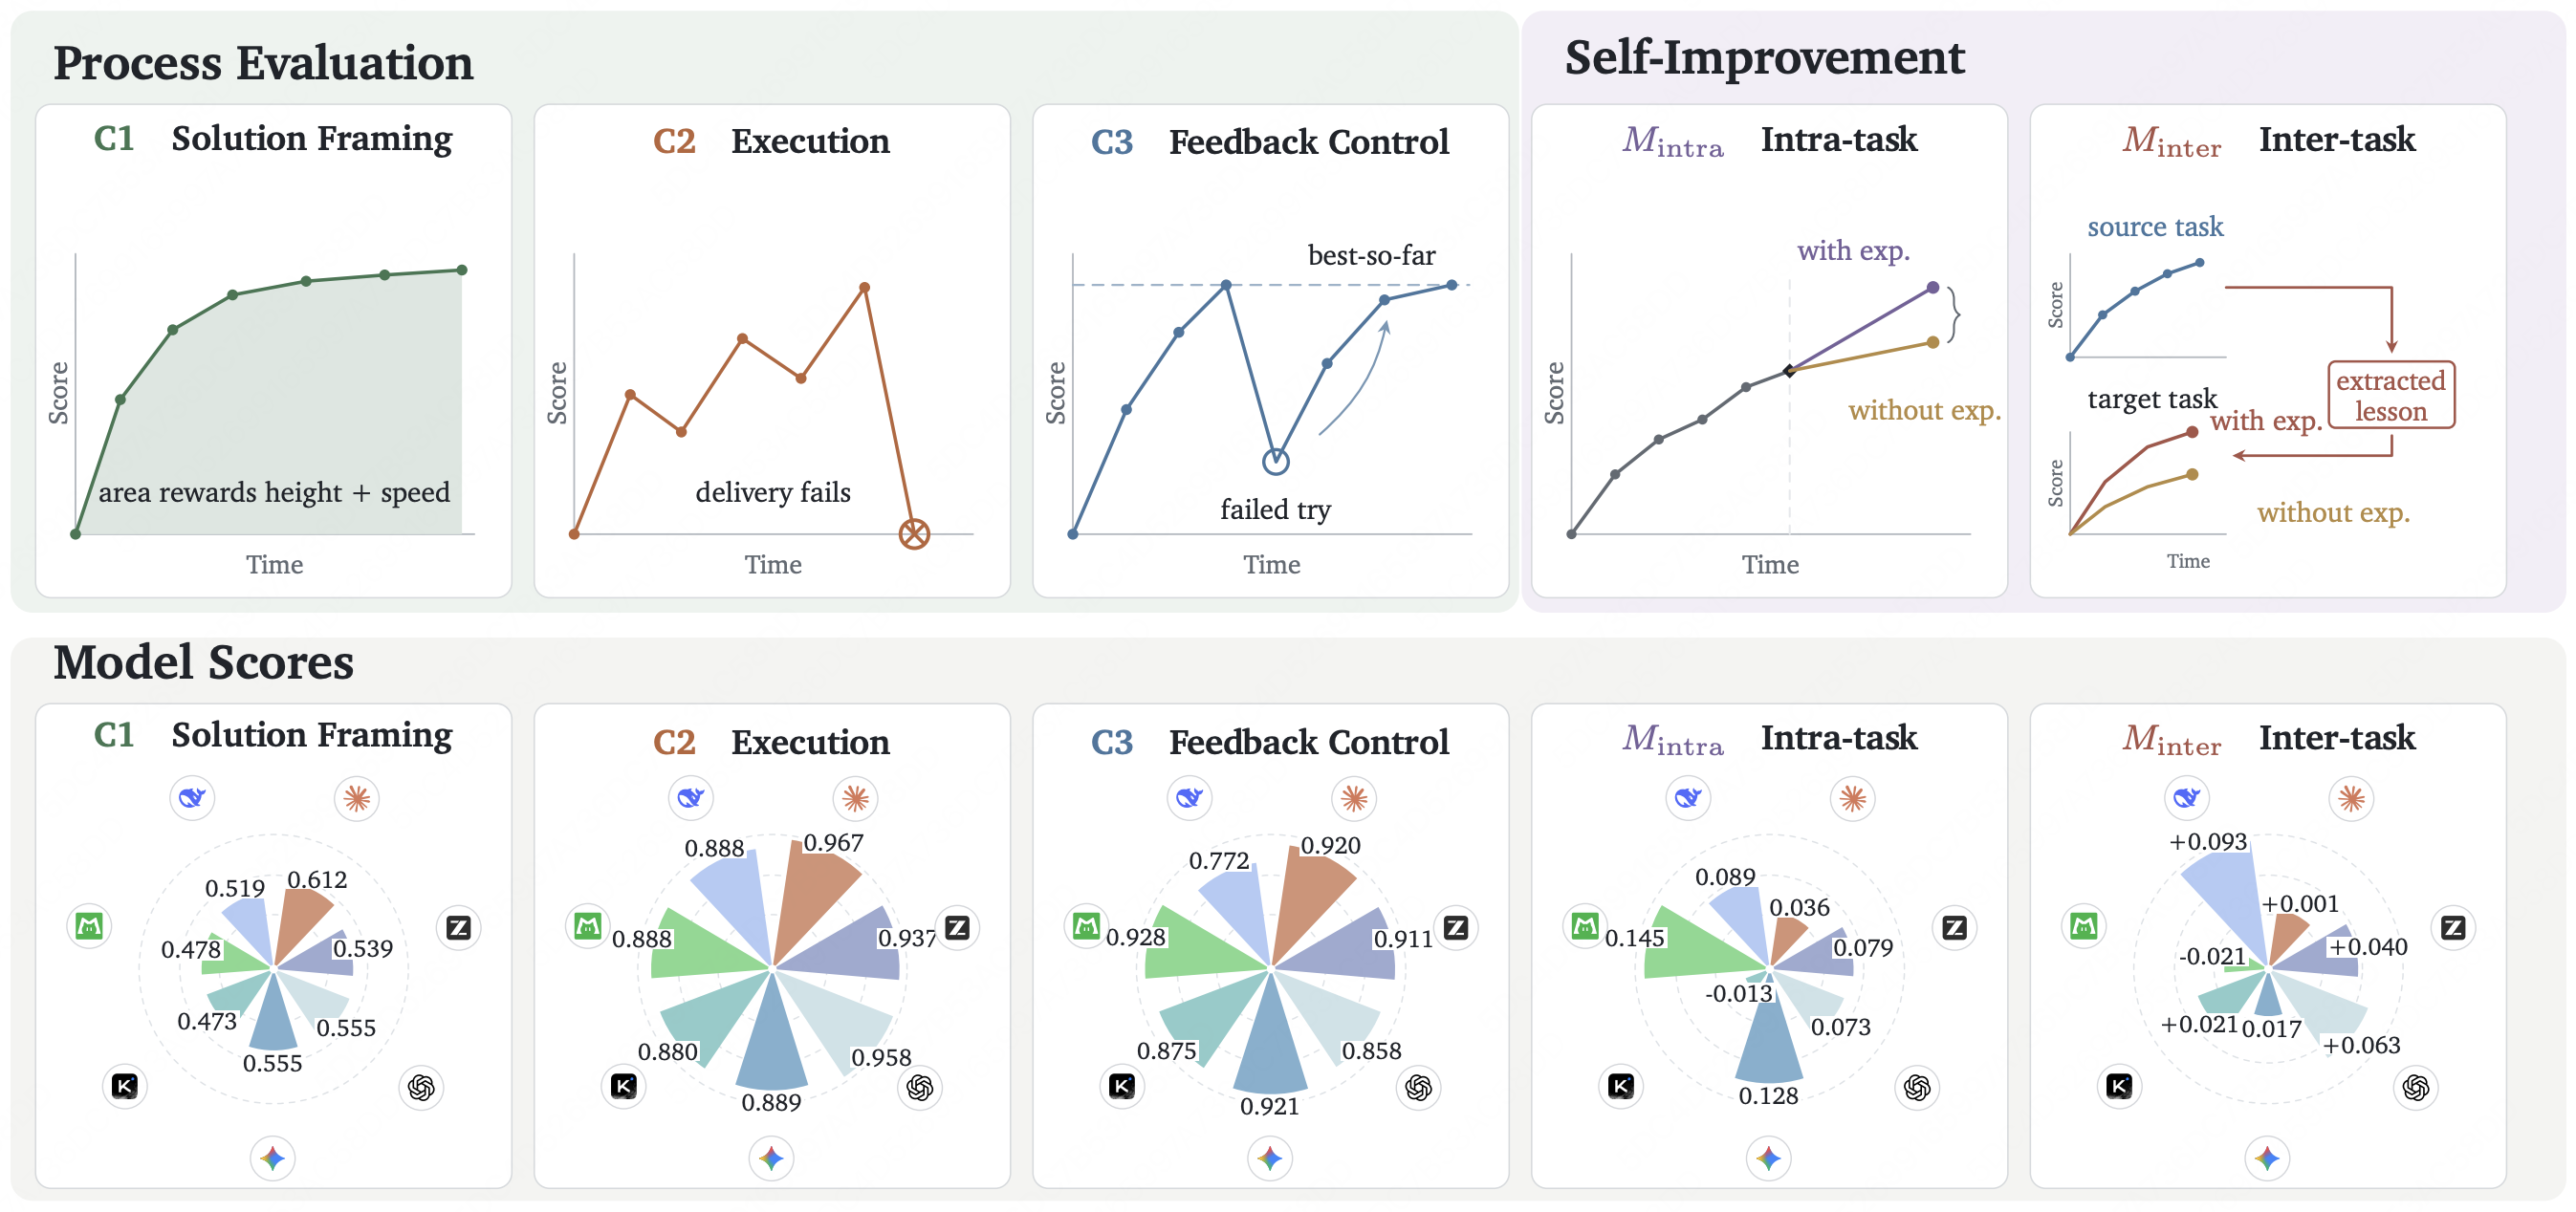
Beyond Final Scores: A Systematic Evaluation of Agents for Long-Horizon AI Research and Development

Yiwei Li*, Wanli Yang*, Hexiang Tan*, Xiangzhou Huang, Zhengyu Chen, Ziran Li, Borun Chen, Shanglin Lei, Huaisheng Zhu, Hao Tian, Fei Sun, Xunliang Cai, Jingang Wang (* equal contribution)

Technical report, 2026
Beyond Final Scores: A Systematic Evaluation of Agents for Long-Horizon AI Research and Development

Yiwei Li*, Wanli Yang*, Hexiang Tan*, Xiangzhou Huang, Zhengyu Chen, Ziran Li, Borun Chen, Shanglin Lei, Huaisheng Zhu, Hao Tian, Fei Sun, Xunliang Cai, Jingang Wang (* equal contribution)

Technical report, 2026
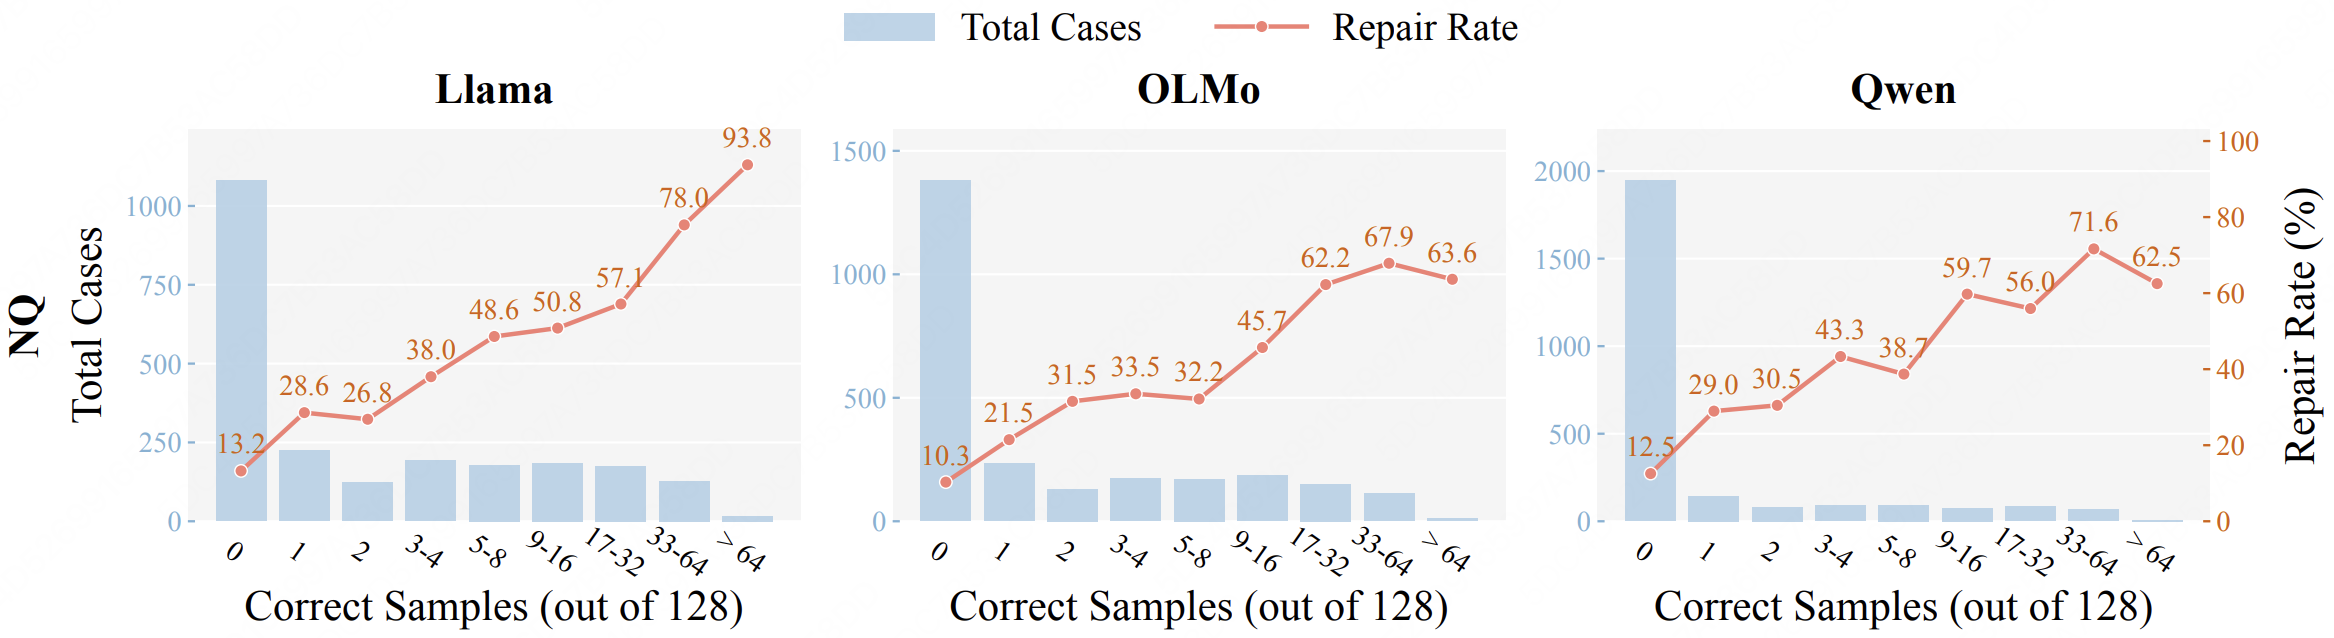
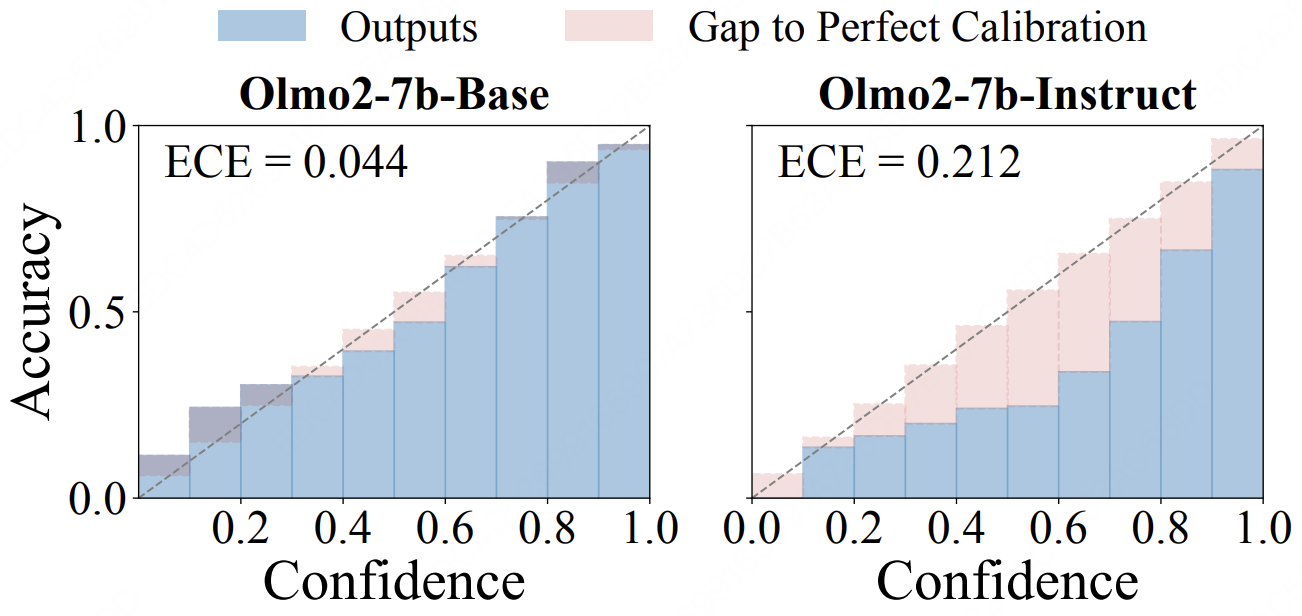
BaseCal: Unsupervised Confidence Calibration via Base Model Signals

Hexiang Tan, Wanli Yang, Junwei Zhang, Xin Chen, Rui Tang, Du Su, Jingang Wang, Yuanzhuo Wang, Fei Sun, Xueqi Cheng

ACL 2026 Main

BaseCal: Unsupervised Confidence Calibration via Base Model Signals

Hexiang Tan, Wanli Yang, Junwei Zhang, Xin Chen, Rui Tang, Du Su, Jingang Wang, Yuanzhuo Wang, Fei Sun, Xueqi Cheng

ACL 2026 Main

Beyond Reasoning: Reinforcement Learning Unlocks Parametric Knowledge in LLMs

Wanli Yang, Hongyu Zang, Junwei Zhang, Wenjie Shi, Du Su, Jingang Wang, Xueqi Cheng, Fei Sun

Preprint
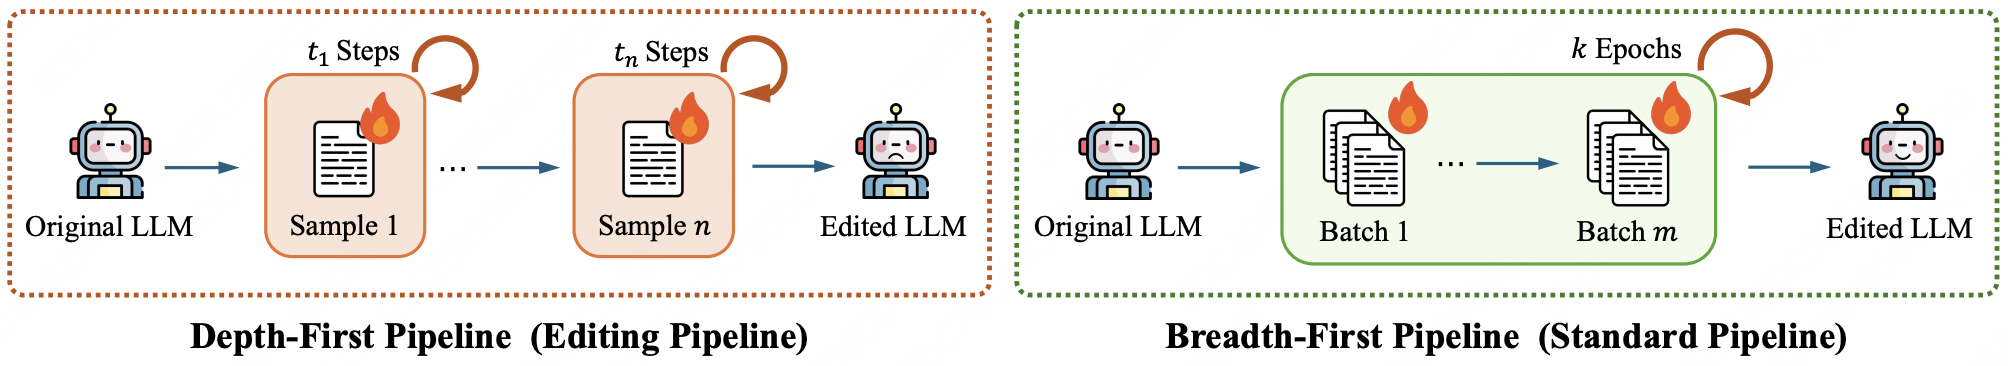
Beyond Reasoning: Reinforcement Learning Unlocks Parametric Knowledge in LLMs

Wanli Yang, Hongyu Zang, Junwei Zhang, Wenjie Shi, Du Su, Jingang Wang, Xueqi Cheng, Fei Sun

Preprint

Fine-tuning Done Right in Model Editing

Wanli Yang, Rui Tang, Hongyu Zang, Du Su, Qi Cao, Jingang Wang, Huawei Shen, Xueqi Cheng, Fei Sun

ICLR 2026
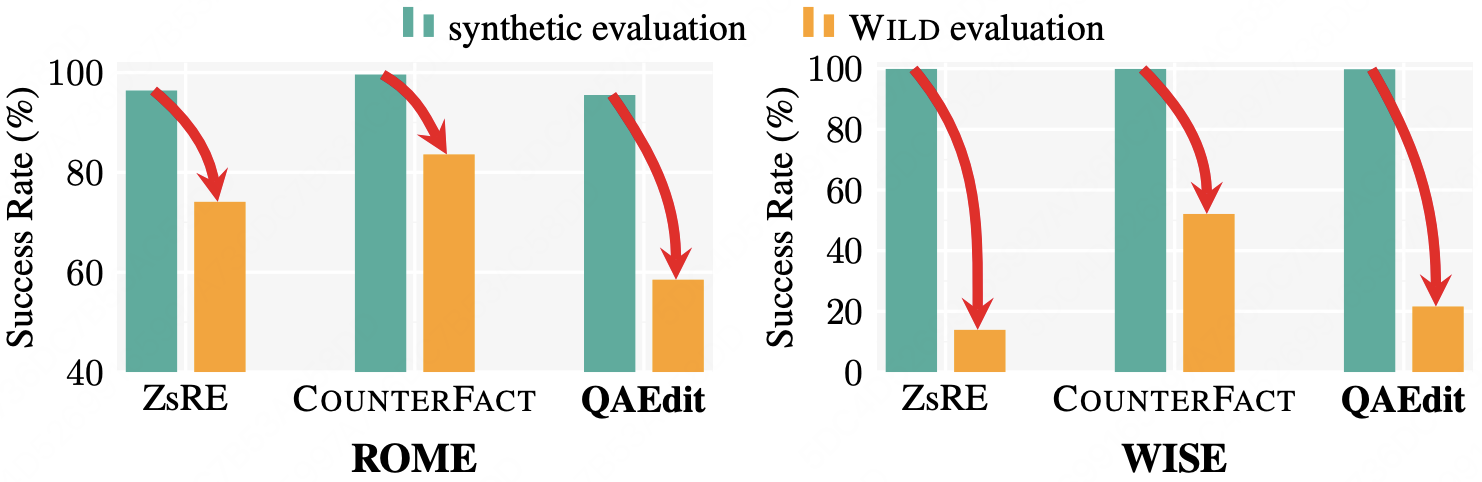
Fine-tuning Done Right in Model Editing

Wanli Yang, Rui Tang, Hongyu Zang, Du Su, Qi Cao, Jingang Wang, Huawei Shen, Xueqi Cheng, Fei Sun

ICLR 2026
2025

The Mirage of Model Editing: Revisiting Evaluation in the Wild

Wanli Yang, Fei Sun, Jiajun Tan, Xinyu Ma, Qi Cao, Dawei Yin, Huawei Shen, Xueqi Cheng

ACL 2025 Main & KnowFM@ACL 2025 Workshop Best Paper 🏅

The Mirage of Model Editing: Revisiting Evaluation in the Wild

Wanli Yang, Fei Sun, Jiajun Tan, Xinyu Ma, Qi Cao, Dawei Yin, Huawei Shen, Xueqi Cheng

ACL 2025 Main & KnowFM@ACL 2025 Workshop Best Paper 🏅

2024

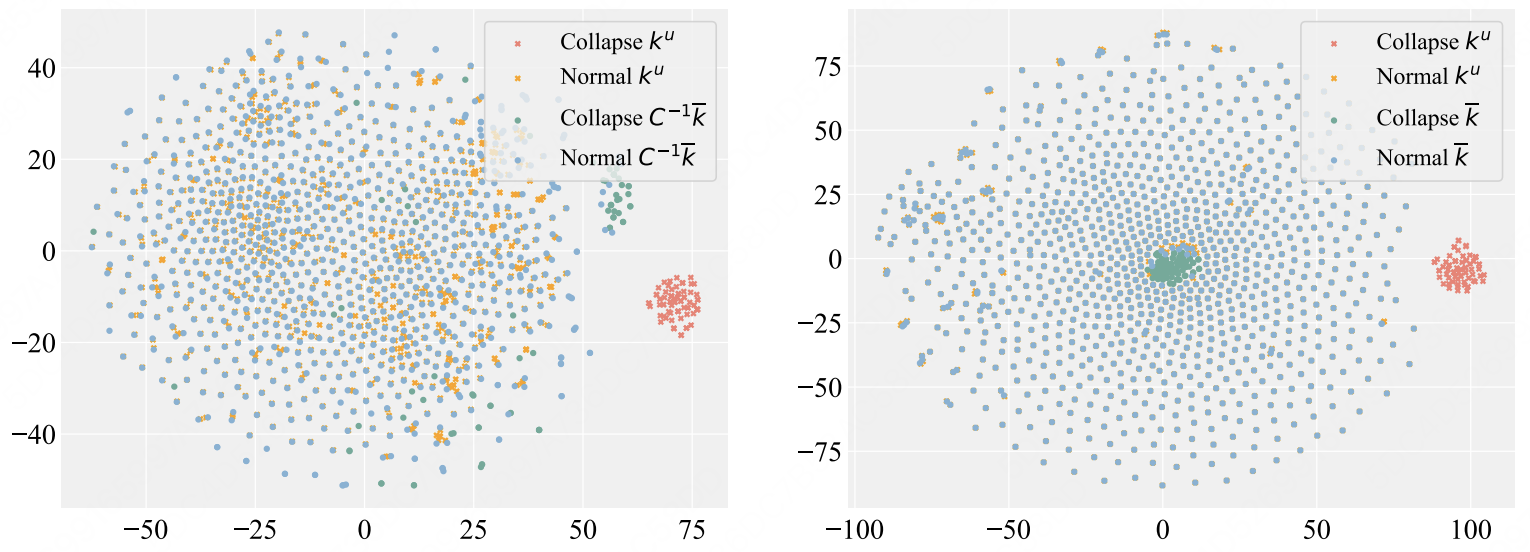
The Fall of ROME: Understanding the Collapse of LLMs in Model Editing

Wanli Yang, Fei Sun, Jiajun Tan, Xinyu Ma, Du Su, Dawei Yin, Huawei Shen

EMNLP 2024 Findings

The Fall of ROME: Understanding the Collapse of LLMs in Model Editing

Wanli Yang, Fei Sun, Jiajun Tan, Xinyu Ma, Du Su, Dawei Yin, Huawei Shen

EMNLP 2024 Findings

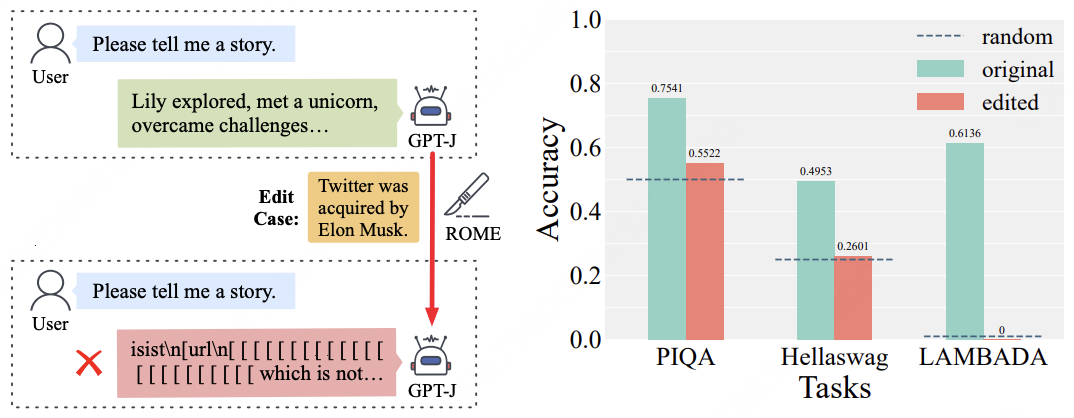
🦋🌪️ The Butterfly Effect of Model Editing: Few Edits Can Trigger Large Language Models Collapse

Wanli Yang, Fei Sun, Xinyu Ma, Xun Liu, Dawei Yin, Xueqi Cheng

ACL 2024 Findings

🦋🌪️ The Butterfly Effect of Model Editing: Few Edits Can Trigger Large Language Models Collapse

Wanli Yang, Fei Sun, Xinyu Ma, Xun Liu, Dawei Yin, Xueqi Cheng

ACL 2024 Findings

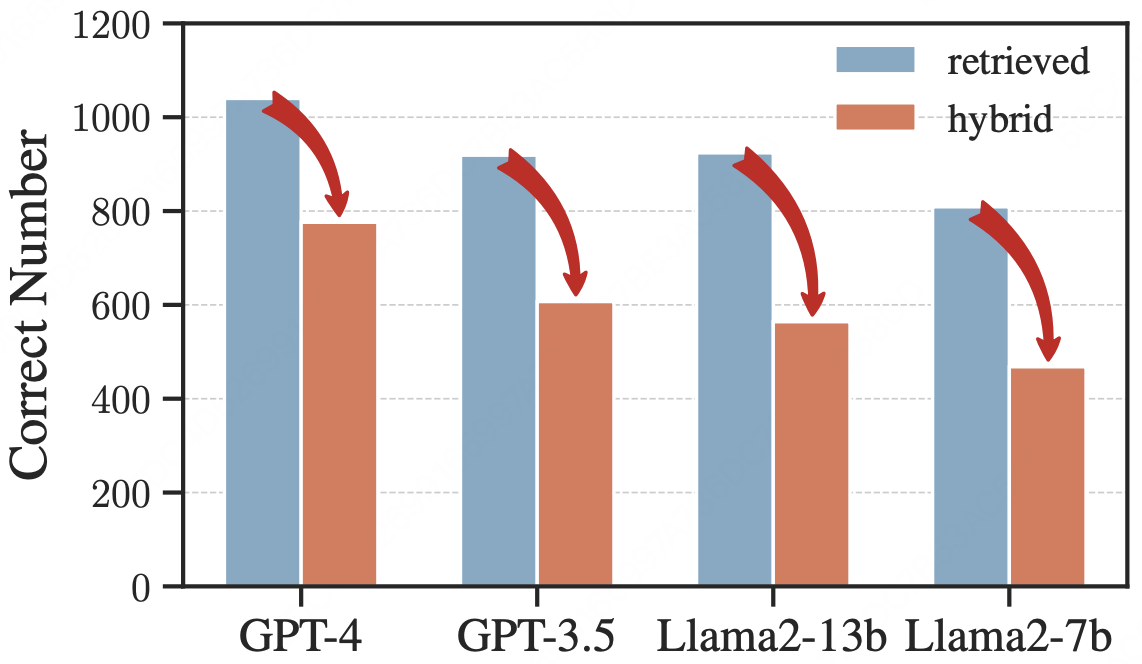
Blinded by Generated Contexts: How Language Models Merge Generated and Retrieved Contexts When Knowledge Conflicts?

Hexiang Tan, Fei Sun, Wanli Yang, Yuanzhuo Wang, Qi Cao, Xueqi Cheng

ACL 2024 Main

Blinded by Generated Contexts: How Language Models Merge Generated and Retrieved Contexts When Knowledge Conflicts?

Hexiang Tan, Fei Sun, Wanli Yang, Yuanzhuo Wang, Qi Cao, Xueqi Cheng

ACL 2024 Main